Die Wissenschaft ist tot – es lebe die Wissenschaft
Über eine Publikationskrise, die generative KI nicht verursacht, aber beschleunigt hat – und warum sie trotzdem ein Ausweg sein kann.
KI
LLMs
Wissenschaft
Publikationen
Governance
Strategie
Warum arXiv Einreichungen begrenzt, KI-Beweise Mathematiker:innen überfordern und Workslop in Unternehmen dasselbe Problem ist: Erzeugen wird billig, Prüfen bleibt teuer.
Die Wissenschaft steckt in einer Krise. Gemeint ist ausnahmsweise nicht das Vertrauen in Fakten, das in Zeiten von Desinformation und „alternativen Fakten“ unter Druck steht. Gemeint ist eine Krise im Maschinenraum: in der Art, wie Forschung veröffentlicht, geprüft und bewertet wird. Sie ist weniger sichtbar, betrifft aber genau das, worauf sich dieses Vertrauen eigentlich stützen sollte.
Zwei Meldungen aus einer Woche
Am 1. Oktober 2026 hat arXiv, der wichtigste Preprint-Server der Informatik, Mathematik und Physik, eine neue Regel eingeführt: Jede Person darf nur noch zwei Arbeiten pro Kalendermonat einreichen und höchstens drei gleichzeitig in der Moderation haben (Boboris 2026). Fünf Tage später veröffentlichte OpenAI auf GitHub 722 mathematische Manuskripte zu 372 Ergebnisfamilien, erzeugt von einem internen, unveröffentlichten Modell (OpenAI 2026b; Schuler 2026).
Beide Meldungen beschreiben dasselbe Problem von zwei Seiten. Wissenschaftliche Texte lassen sich inzwischen schneller erzeugen, als Menschen sie lesen, prüfen und einordnen können. Der Engpass der Wissenschaft liegt damit nicht mehr bei der Produktion von Ergebnissen, sondern bei ihrer Überprüfung.
Der Titel dieses Beitrags ist bewusst zugespitzt. Ich glaube nicht, dass Wissenschaft stirbt. Ich glaube aber, dass ein bestimmtes Modell von Wissenschaft an seine Grenzen kommt: das Modell, in dem Publikationen gezählt werden, Begutachtung unbezahlt nebenher erledigt wird und Qualitätssicherung darauf beruht, dass das Schreiben eines Papers mühsam ist. Aus meiner Sicht hat generative KI diese Krise nicht ausgelöst, sondern ein lange bestehendes Ungleichgewicht sichtbar gemacht. Und genau deshalb kann sie auch Teil der Lösung sein.
HinweisKurz erklärt: Wie Peer Review funktioniert
Bevor es um die Krise geht, lohnt ein Blick darauf, wie wissenschaftliche Qualitätssicherung überhaupt funktioniert. Wer ein Forschungsergebnis veröffentlichen möchte, reicht ein Manuskript bei einer Fachzeitschrift oder einer Konferenz ein. Zunächst prüft die Herausgeberschaft, ob die Arbeit thematisch passt und grundlegende Standards erfüllt. Ein Teil der Einreichungen wird bereits an dieser Stelle abgelehnt, im Jargon desk reject.
Die übrigen Manuskripte gehen an meist zwei bis drei Fachleute aus demselben Gebiet, die Gutachter:innen oder Reviewer. Sie prüfen Fragestellung, Methode, Daten und Schlussfolgerungen und schreiben ein Gutachten mit einer Empfehlung: annehmen, kleinere oder größere Überarbeitung, ablehnen. Die Gutachten sind in der Regel anonym; häufig kennen auch die Gutachter:innen die Namen der Autor:innen nicht (double blind). Nach einer oder mehreren Überarbeitungsrunden entscheidet die Herausgeberschaft. Bis zur Veröffentlichung vergehen so oft Monate.
Für diesen Text sind drei Eigenschaften des Systems wichtig. Erstens ist Begutachtung fast immer unbezahlt. Sie gilt als Dienst an der Fachgemeinschaft und wird neben Forschung und Lehre erledigt; Aczel, Szaszi, und Holcombe (2021) rechnen mit etwa sechs Stunden pro Gutachten. Zweitens sind die Gutachter:innen dieselben Menschen, die selbst publizieren. Wer mehr schreibt, erzeugt also mehr Begutachtungsbedarf bei anderen. Drittens skaliert das Verfahren nur mit menschlicher Aufmerksamkeit, und die ist begrenzt.
Preprint-Server wie arXiv funktionieren anders. Dort werden Arbeiten vor oder parallel zur Begutachtung öffentlich gemacht, damit Ergebnisse schnell zugänglich sind. arXiv führt selbst kein Peer Review durch. Freiwillige Moderator:innen prüfen lediglich, ob eine Einreichung wissenschaftlichen Mindeststandards genügt, für die Fachcommunity von Interesse ist und in die richtige Kategorie fällt (Boboris 2026). Ausgerechnet diese vergleichsweise leichte Prüfung stößt nun an ihre Grenzen.
Wie wir hierhin gekommen sind
Um die heutige Lage zu verstehen, lohnt ein kurzer Blick zurück. Lange Zeit war wissenschaftliches Publizieren für Autor:innen kostenlos. Bezahlt wurde für das Lesen: Bibliotheken schlossen Abonnements mit Verlagen ab, und diese Abonnements wurden über Jahrzehnte immer teurer.
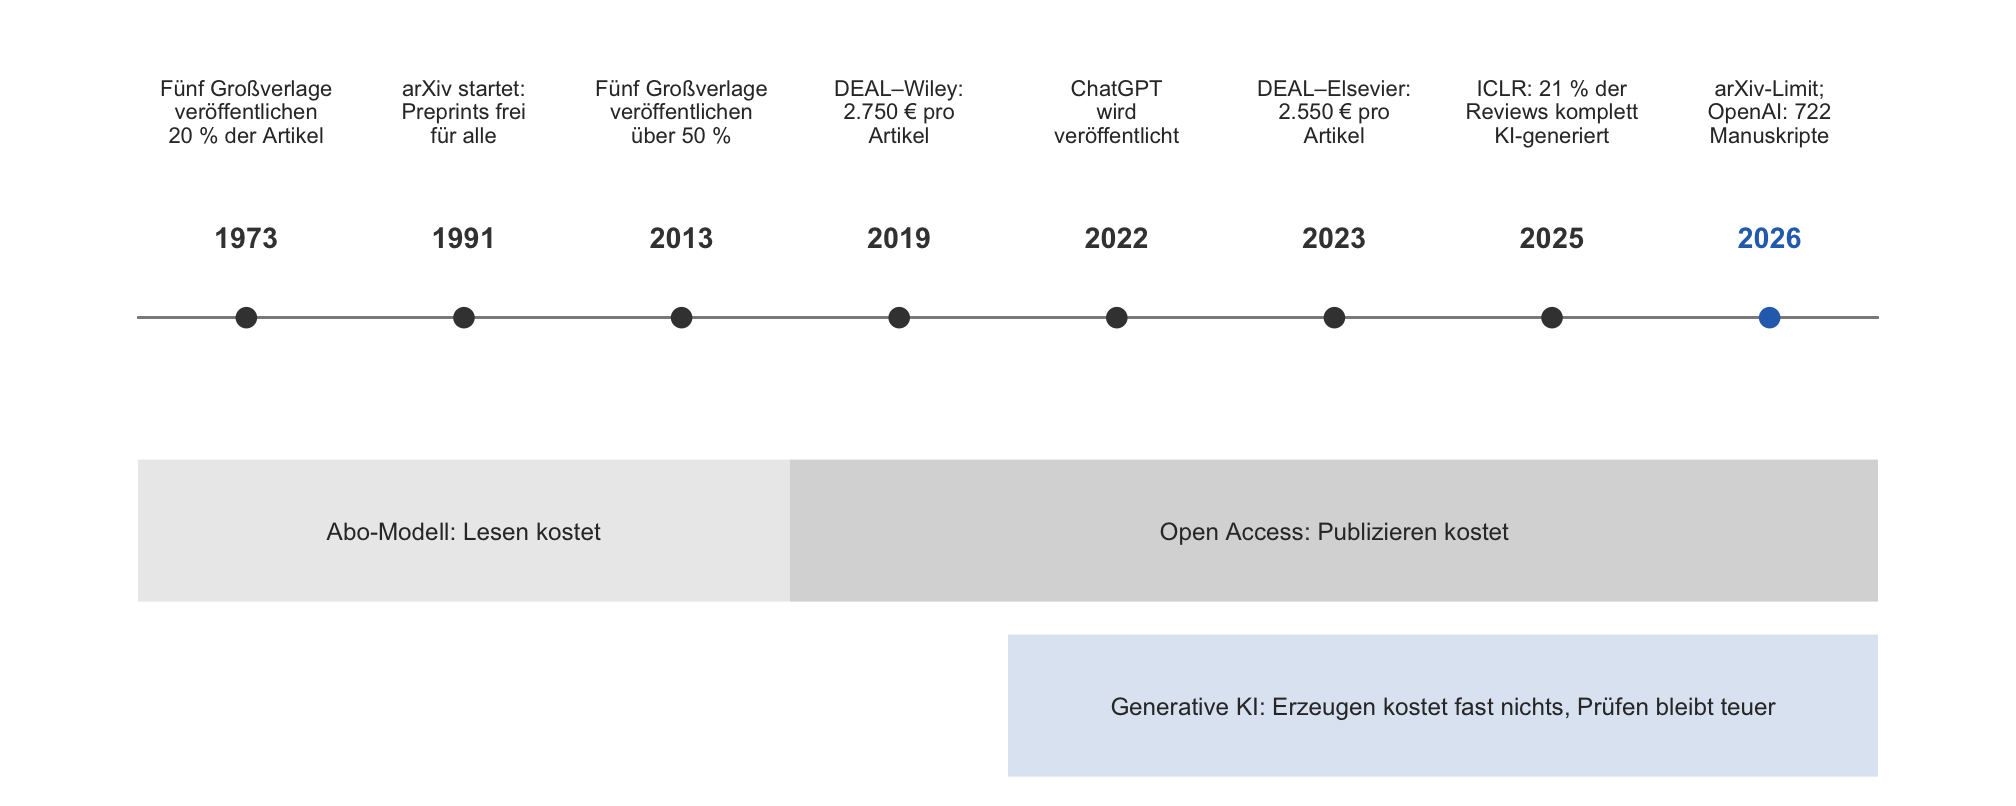
Gleichzeitig konzentrierte sich der Markt. Larivière, Haustein, und Mongeon (2015) zeigen auf Basis von 45 Millionen Dokumenten, dass die fünf größten Verlage 1973 rund 20 Prozent aller Artikel veröffentlichten, 2013 dagegen mehr als die Hälfte. Die Digitalisierung hat die Verbreitung von Wissen nicht demokratisiert, sondern zunächst vor allem die großen kommerziellen Anbieter gestärkt.
Das Geschäftsmodell ist bemerkenswert profitabel. Die Sparte Scientific, Technical & Medical von RELX, zu der Elsevier gehört, erzielte 2025 eine bereinigte operative Marge von 38,1 Prozent (RELX 2026). Ein wesentlicher Teil der Wertschöpfung wird dabei unentgeltlich erbracht: Aczel, Szaszi, und Holcombe (2021) schätzen, dass Gutachter:innen weltweit im Jahr 2020 mehr als 100 Millionen Stunden mit Peer Review verbracht haben. Allein für die USA entspricht das einem Gehaltswert von über 1,5 Milliarden US-Dollar.
Open Access hat das Problem verschoben
Die Open-Access-Bewegung war die richtige Antwort auf verschlossene Wissenschaft. In Deutschland hat das Projekt DEAL bundesweite Verträge mit den großen Verlagen ausgehandelt. Der erste Vertrag mit Wiley sah 2019 eine Publish-and-Read-Gebühr von 2.750 Euro pro Artikel vor; vorher war das Publizieren selbst für Autor:innen kostenlos (Dobusch 2019). Der Vertrag mit Elsevier folgte 2023 mit 2.550 Euro pro Artikel (open-access.network 2023).
Damit hat sich die Logik umgekehrt. Lesen ist frei, Publizieren kostet. Für Verlage bedeutet das: Der Umsatz hängt nicht mehr an der Zahl der Leser:innen, sondern an der Zahl der veröffentlichten Artikel. RELX beschreibt das Wachstum im Bereich Primary Research selbst als volumengetrieben und verweist auf stark steigende Einreichungen, insbesondere im Pay-to-publish-Segment (RELX 2025).
Diese Logik hat schon lange vor generativer KI seltsame Blüten getrieben. Sogenannte Raubverlage (predatory publishers) verkaufen Veröffentlichungen ohne nennenswerte Begutachtung und veranstalten Konferenzen, bei denen die Teilnahmegebühr faktisch die Publikation garantiert. Gegen die bekannteste, die OMICS Group, verhängte ein US-Bundesgericht 2019 auf Klage der Handelsbehörde FTC mehr als 50 Millionen US-Dollar, unter anderem wegen vorgetäuschter Begutachtung (Federal Trade Commission 2019). Und schon 2014 mussten Springer und IEEE mehr als 120 Konferenzbeiträge zurückziehen, die das Programm SCIgen als sinnlosen Text erzeugt hatte. Aufgefallen waren sie nicht im Begutachtungsprozess, sondern erst Jahre später (Van Noorden 2014). Raubverlage sind ein Randphänomen. Sie zeigen aber in extremer Form, wohin ein Anreiz führt, der auch seriöse Verlage betrifft: Wer an jeder Veröffentlichung verdient, hat wenig Interesse daran, dass weniger veröffentlicht wird.
Hanson u. a. (2024) haben diese Entwicklung als strain on scientific publishing beschrieben. Die Zahl der in Scopus und Web of Science indexierten Artikel lag 2022 rund 47 Prozent über dem Wert von 2016, während die Zahl der aktiven Wissenschaftler:innen kaum gewachsen ist. Pro Person steigt also die Last für Schreiben, Begutachten und Editieren. Das war der Stand, bevor generative KI breit verfügbar wurde.
Die Flut: arXiv zieht die Notbremse
Generative KI trifft also auf ein System, das bereits unter Druck stand. Am deutlichsten zeigt sich das bei arXiv, weil die Plattform ihre Zahlen offenlegt. Im September 2016 gingen 9.869 Einreichungen ein, im September 2024 waren es 20.569 und im September 2026 40.363 – ein neuer Rekord. Die Zahl hat sich in nur zwei Jahren verdoppelt; in der Kategorie cs.AI sogar mehr als versechsfacht (Boboris 2026).
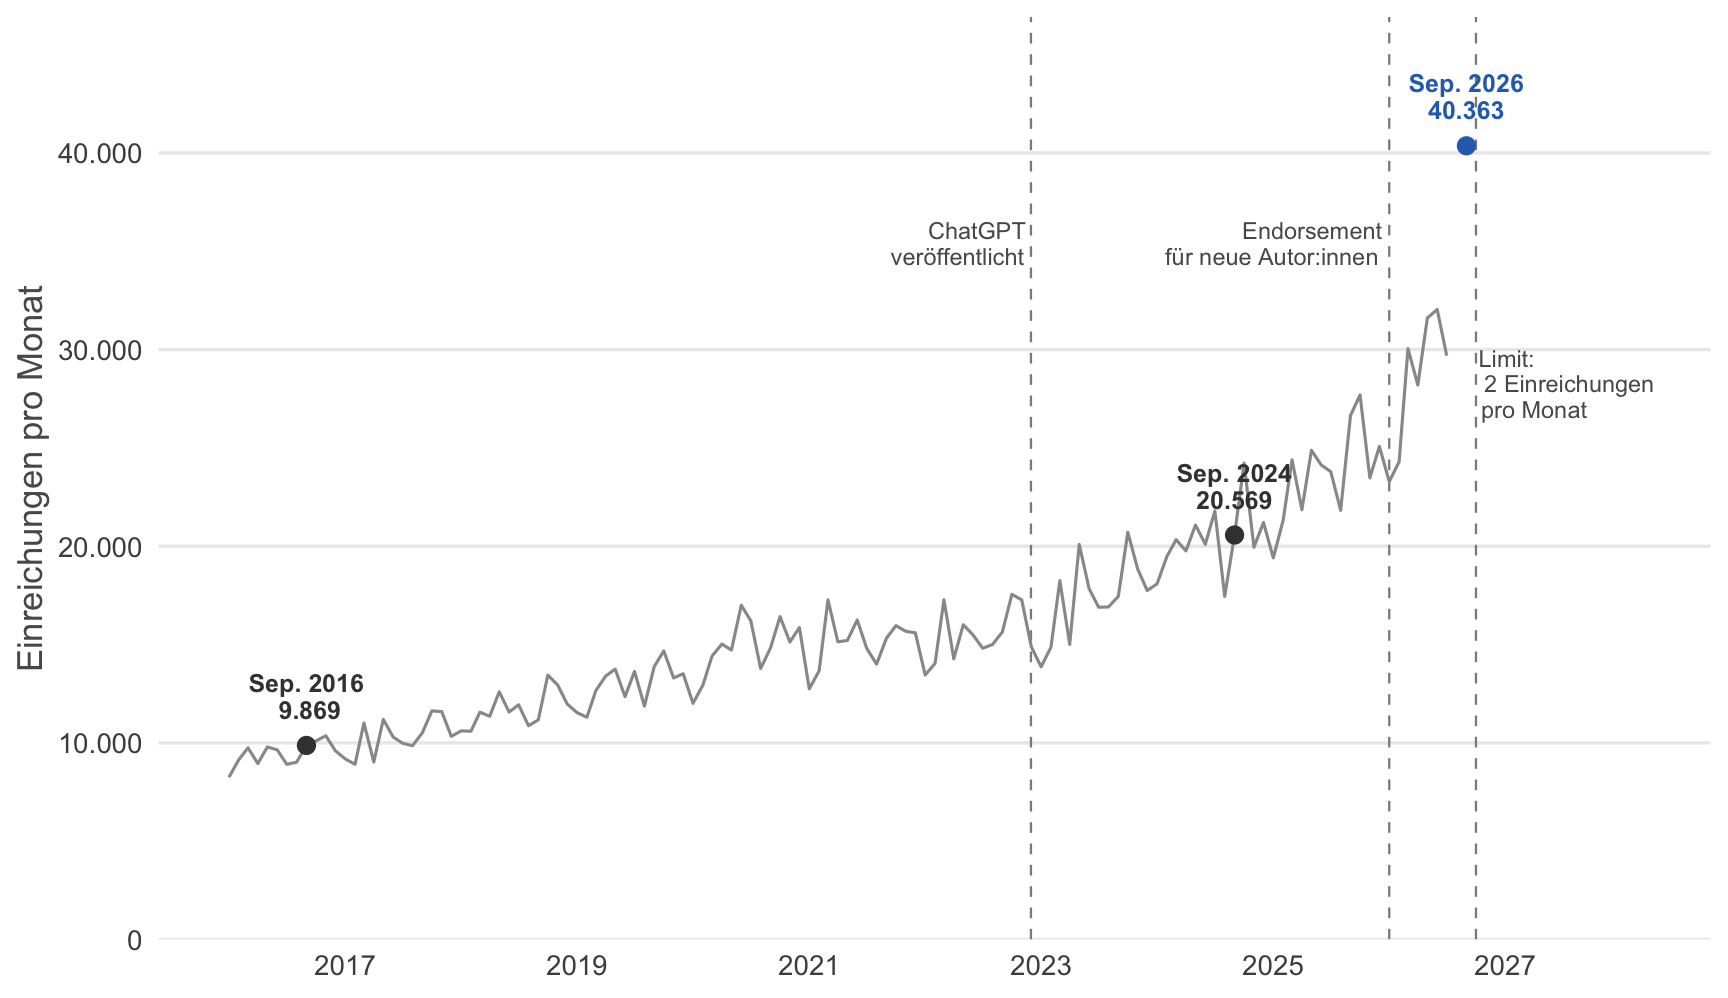
arXiv betont, dass KI als Werkzeug ausdrücklich erlaubt ist, sofern ihre Nutzung offengelegt wird und die Arbeit einen wissenschaftlichen Beitrag leistet. Viele der neuen Einreichungen erfüllen diese Anforderungen jedoch nicht. Die Moderator:innen beobachten mehr dünne Arbeiten mit engem Fokus, mehr in Scheiben geschnittene „Salami”-Paper und deutlich mehr dichte, KI-geschriebene Texte. Allein im September 2026 entstanden fast 9.000 Support-Tickets für ein Team, das überwiegend aus Freiwilligen besteht (Boboris 2026).
Das Limit ist dabei nur der vorerst letzte Schritt. Seit Oktober 2025 nimmt arXiv Übersichtsartikel und Positionspapiere in der Informatik nur noch an, wenn sie bereits in einer Zeitschrift oder auf einer Konferenz begutachtet und angenommen wurden; monatlich gingen Hunderte solcher Texte ein, viele kaum mehr als kommentierte Literaturlisten (Boboris 2025). Seit Januar 2026 reicht neuen Autor:innen eine institutionelle E-Mail-Adresse nicht mehr aus. Sie brauchen eine bereits angenommene arXiv-Arbeit oder die Empfehlung, das sogenannte Endorsement, einer etablierten Person (arXiv 2025). Und seit Mai 2026 droht eine einjährige Sperre, wenn Einreichungen eindeutige Spuren ungeprüfter KI-Ausgaben enthalten, etwa erfundene Quellen oder stehengebliebene Chatbot-Kommentare (Grove 2026).
arXiv ist dabei kein Einzelfall. bioRxiv und medRxiv, die Preprint-Server für Biologie und Medizin, lehnten bereits 2025 täglich mehr als zehn formelhafte, möglicherweise KI-generierte Manuskripte ab (Watson 2025; zusammengefasst bei Price 2025). Beim kleineren Engineering Archive (engrXiv) stieg die Zahl der monatlichen Einreichungen von durchschnittlich 60 auf fast 200 (engrXiv 2025).
Bemerkenswert ist, wie arXiv das neue Limit zählt: Maßgeblich ist jede Einreichung, nicht nur jede angenommene Arbeit. Auch ein abgelehnter Text verbraucht also einen der zwei monatlichen Plätze, denn auch seine Prüfung kostet Moderationszeit. Begründet wird das damit, dass ein relativ kleiner Teil der Autor:innen sehr viele minderwertige Arbeiten einreicht und so die Arbeiten aller anderen um Tage oder Wochen verzögert (Boboris 2026). Das Limit ist umstritten: Kritiker:innen bemängeln, dass ein pauschales Limit Qualität nicht von Quantität unterscheidet und kleine Gruppen stärker trifft als große (Times Higher Education 2026).
Auch auf der Gutachterseite hält KI Einzug. Pangram Labs, ein Anbieter von KI-Detektoren, stufte rund 21 Prozent der Reviews für die KI-Konferenz ICLR 2026, insgesamt 15.899, als vollständig KI-generiert ein; mehr als die Hälfte zeigte zumindest Spuren von KI-Nutzung (Pangram Labs 2025; Naddaf 2025). Wenn KI-geschriebene Arbeiten von KI-geschriebenen Gutachten bewertet werden, ist die Frage berechtigt, wer hier eigentlich noch prüft.
Parallel entsteht ein Markt, der die Überlastung monetarisiert. Pottarath, Halffman, und Horbach (2026) fanden allein im Februar 2026 mehr als 1.000 LinkedIn-Anzeigen für „freiberufliche“ Gutachter:innen, meist ausgeschrieben von Dienstleistern, die für Verlage Teile der Begutachtung übernehmen. Die befragten Gutachter:innen berichten von 30 bis 40 Euro pro Gutachten und Fristen von meist zwei bis drei Tagen. Begutachtung wird so, wie die Autor:innen schreiben, von einem Dienst an der Fachgemeinschaft zu einer individuellen, schnellen Transaktion. Fachleute für Forschungsintegrität warnen, dass solche Schnellgutachten unbemerkt mit KI geschrieben und von Paper Mills genutzt werden könnten, um gefälschten Arbeiten einen seriösen Anstrich zu geben (Naddaf 2026).
Publikationen als Währung
Hinter der Flut steht ein Anreizsystem, das älter ist als jede KI. In der Wissenschaft sind Publikationen die Währung, in der Leistung gemessen wird. Sie entscheiden über Promotion, Stellen, Drittmittel und Berufungen. Wer eine akademische Karriere anstrebt, muss in begrenzter Zeit genug sichtbare Arbeiten vorweisen, meist auf befristeten Stellen.
Den größten Druck spüren dabei nicht die Etablierten, sondern die Jüngeren. In einer Befragung an vier Amsterdamer Einrichtungen berichteten Postdocs und Assistant Professors von der höchsten Publikationsbelastung; Promovierenden fehlten am ehesten Ressourcen, um diesen Druck abzufedern (Haven u. a. 2019). Der Druck nimmt zudem zu: Im Report Researcher of the Future gaben 68 Prozent von mehr als 3.200 Befragten an, heute stärker unter Publikationsdruck zu stehen als vor zwei bis drei Jahren. Nur 45 Prozent hatten nach eigener Einschätzung genug Zeit für Forschung (Elsevier 2025).
Das Open-Access-Modell verschärft die Lage für genau diese Gruppe. Wo Publizieren Geld kostet, hängt die Sichtbarkeit einer Arbeit auch davon ab, ob jemand die Gebühr bezahlen kann. In einer Befragung der AAAS unter 422 US-Forschenden fand gut die Hälfte derjenigen, die bereits Publikationsgebühren bezahlt hatten, es schwierig oder sehr schwierig, die Mittel dafür aufzutreiben. Mehr als drei Viertel verzichteten dafür auf Material, Geräte oder Werkzeuge (AAAS 2022). Wer ohne eigenes Projektbudget arbeitet, und das sind häufig Promovierende und Postdocs, ist auf institutionelle Verträge wie DEAL oder auf das Budget der Arbeitsgruppe angewiesen.
Vor diesem Hintergrund liegt die Vermutung nahe, dass Publikationsdruck auch die Hemmschwelle senkt, KI einzusetzen. Direkt belegt ist dieser Zusammenhang meines Wissens bislang nicht, die Hinweise gehen aber in diese Richtung. Höherer Publikationsdruck geht mit einer, wenn auch schwach, größeren Bereitschaft einher, ethische Standards zu verletzen (Paruzel-Czachura, Baran, und Spendel 2021). Forschende mit weniger als drei Jahren Berufserfahrung nutzen KI häufiger für Recherche und Textüberarbeitung als Erfahrene, 48 gegenüber 34 Prozent (Springer Nature 2026). Und eine Simulation von Jiang (2025) zeigt, wie stark ein an Publikationszahlen orientiertes Tenure-System frühe KI-Anwender:innen belohnen würde.
Das ist kein Vorwurf an junge Forschende, sondern eine rationale Reaktion auf ein System, das Menge belohnt. Wer auf KI verzichtet, während andere sie nutzen, riskiert im Wettbewerb um wenige unbefristete Stellen zurückzufallen. Deshalb wird sich das Problem nicht allein durch Regeln für Autor:innen lösen lassen, sondern nur durch veränderte Bewertungsmaßstäbe.
Auch ehrliche Forschung wird schneller
Es wäre bequem, das Problem allein bei Paper Mills und unseriösen Autor:innen zu verorten. Das greift aber zu kurz. Auch wer ethisch sauber arbeitet, KI-Nutzung offenlegt und jedes Ergebnis selbst prüft, wird schneller.
Das merke ich an meiner eigenen Arbeit. Literaturrecherche, Datenaufbereitung, Analysecode und erste Textentwürfe gehen mit KI-Unterstützung deutlich schneller als noch vor zwei Jahren. Die Ideen und die Verantwortung für die Ergebnisse bleiben bei mir. Aber der Weg von einer Idee zu einem einreichbaren Manuskript ist kürzer geworden.
Für das System insgesamt ist das eine einfache Rechnung. Wenn jede Forscherin und jeder Forscher legitim 30 oder 50 Prozent mehr Manuskripte fertigstellt, steigt die Zahl der benötigten Gutachten im selben Maß. Die Gutachter:innen sind aber dieselben Personen, die gerade selbst mehr schreiben. Der Zeitaufwand für ein sorgfältiges Review ist nicht kleiner geworden; er ist eher gestiegen, weil man bei glatt formulierten Texten genauer hinsehen muss. Die Kapazität für Prüfung wächst also nicht mit der Kapazität für Produktion.
Von Literaturreviews zu mathematischen Beweisen
Lange Zeit schien das Problem auf bestimmte Textsorten begrenzt. Übersichtsartikel, Literaturrecherchen und inkrementelle empirische Arbeiten ließen sich mit Sprachmodellen gut beschleunigen. Mathematische Beweise galten dagegen als Bereich, in dem KI höchstens assistiert.
Das hat sich in diesem Herbst grundlegend verändert. Nach zehn Ergebnissen im August und einem beanspruchten Beitrag zu den Navier-Stokes-Gleichungen im September stellte OpenAI am 6. Oktober 372 Ergebnisfamilien vor. Jede soll eine offene mathematische Frage lösen oder wesentlich voranbringen, darunter ein beanspruchter Beweis der Unique Games Conjecture (Schuler 2026). Gestellt wurden dem Modell nach Angaben von OpenAI rund 4.000 Probleme; ein Ergebnis benötigte im Mittel Rechenzeit im Umfang von etwa drei Stunden ChatGPT-Pro-Nachdenken (OpenAI 2026b, 2026a).
HinweisKurz erklärt: Was ist Lean?
Lean taucht in der Debatte um KI-Beweise immer wieder auf. Es ist eine quelloffene Programmiersprache und ein sogenannter Beweisassistent, den heute die gemeinnützige Lean FRO weiterentwickelt (Lean FRO 2026). Mathematische Aussagen und Beweise werden darin so präzise aufgeschrieben, dass ein Computer jeden einzelnen Schritt auf logische Korrektheit prüfen kann. Grundlage ist die gemeinschaftlich gepflegte Bibliothek Mathlib, die inzwischen rund 290.000 formalisierte Sätze enthält (Lean Community 2026). Akzeptiert Lean einen Beweis, muss für die Korrektheit der einzelnen Schritte niemand mehr dem Urteil einer Gutachterin vertrauen.
Für meine Argumentation ist weniger die Frage entscheidend, wie viele der OpenAI-Ergebnisse am Ende Bestand haben. Wichtiger ist, wo die Prüfarbeit landet. Nach Angaben im Repository sind rund 42 Prozent der Hauptresultate in Lean formalisiert, also von einem Computer Schritt für Schritt überprüft. Für die übrigen Ergebnisse räumt OpenAI selbst ein, dass sie Fehler enthalten könnten (OpenAI 2026a). Drei Manuskripte wurden nach einem Vorzeichenfehler bereits einen Tag nach der Veröffentlichung zurückgezogen, 14 weitere überarbeitet (Schuler 2026).
Selbst die formal geprüften Beweise sind damit nicht automatisch verstanden. Der Komplexitätstheoretiker Aaronson (2026) schrieb einen Tag nach der Veröffentlichung, dass offenbar noch kein Mensch nahezu einen dieser Beweise verstanden habe. In seinem Blog gibt er auch Dana Moshkovitz wieder, die jahrelang an der Unique Games Conjecture gearbeitet hat: Sie beschrieb den Beweis als so schlecht geschrieben, dass sie ihn nur mit KI-Hilfe lesen konnte. Nach Angaben eines OpenAI-Sprechers haben auch die eigenen Mathematiker:innen viele der Ergebnisse noch nicht nachvollzogen (Schuler 2026).
Hier zeigt sich die Asymmetrie besonders deutlich. Die Erzeugung von über 700 Manuskripten kostete Rechenzeit. Ihre Prüfung, Einordnung und Verständlichmachung kostet die Lebenszeit von Expert:innen, die dafür weder angefragt noch bezahlt wurden. Lean hilft, weil es die logische Korrektheit eines Beweises mechanisch absichert. Ob die formale Aussage der gemeinten Vermutung entspricht, ob das Ergebnis interessant ist und was es für das Feld bedeutet, muss weiterhin ein Mensch beurteilen. Eine Beratungsgruppe am Institute for Advanced Study hatte deshalb vorab gefordert, für jedes Ergebnis Modell, Prompts, Rechenaufwand und eine Zusammenfassung des Lösungswegs offenzulegen. OpenAI veröffentlichte Durchschnittswerte und zehn Zusammenfassungen, aber keine Prompts (Schuler 2026).
Wie groß das Unbehagen in der Mathematik ist, zeigt die Erklärung A Severe Misalignment of AI in Mathematics, veröffentlicht am 11. September 2026, wenige Tage nach der Navier-Stokes-Ankündigung. Unterzeichnet haben sie inzwischen 28 Fields-Medaillenträger:innen, darunter Terence Tao, Peter Scholze und Maryna Viazovska. Sie halten es für schädlich, dass KI-Unternehmen mathematische Probleme als Benchmarks nutzen: Das Lösen von Problemen sei nur Werkzeug und Stellvertreter für das eigentliche Ziel, konzeptionelles Verständnis. Massenhaft produzierte Ergebnisse könnten den Boden für neue Ideen eher zerstören als bereiten. Ohne Mathematiker:innen, die KI-erzeugte Ideen aufnehmen und weitergeben, gehe zudem die menschliche Überlieferungskette des Fachs verloren. Überstürzte Ankündigungen ließen keine Zeit für Ausarbeitung und Zitation und würfen ernste Fragen nach Urheberschaft und Plagiat auf (Avila u. a. 2026). Ein Verbot fordern die Unterzeichnenden nicht. Ob KI der Mathematik nützt oder schadet, liege an menschlichen Entscheidungen; Fachgemeinschaft, KI-Unternehmen und Gesellschaft müssten dringend handeln.
Dasselbe Muster in Unternehmen: Workslop
Man könnte das alles für ein akademisches Spezialproblem halten. Ich glaube, das Gegenteil ist der Fall. Wissenschaft ist nur der Bereich, in dem das Problem am besten gemessen wird.
In Unternehmen läuft derselbe Mechanismus ab, nur ohne öffentliche Statistik. Wo KI eingesetzt wird, entsteht mehr Output: mehr Präsentationen, mehr Berichte, mehr E-Mails, mehr Code, mehr Konzeptpapiere. Die Prüfkapazität bleibt dagegen weitgehend gleich. Sie liegt bei Führungskräften, Kolleg:innen und Fachexpert:innen, die das Ergebnis lesen, verstehen und verantworten müssen.
Niederhoffer u. a. (2025) haben dafür in der Harvard Business Review den Begriff Workslop geprägt: KI-erzeugte Arbeitsergebnisse, die nach guter Arbeit aussehen, aber nicht genug Substanz haben, um eine Aufgabe tatsächlich voranzubringen. In ihrer Befragung von US-Beschäftigten gaben rund 40 Prozent an, im vergangenen Monat solche Ergebnisse erhalten zu haben; pro Fall kostete die Nacharbeit im Durchschnitt knapp zwei Stunden. Hochgerechnet auf die Gehälter der Befragten entspricht das nach Axios (2025) unsichtbaren Kosten von etwa 186 US-Dollar pro Person und Monat.
Der Kern des Problems ist derselbe wie bei arXiv. Workslop verlagert kognitive Arbeit von der Person, die etwas erzeugt, auf die Person, die es empfängt. Wer einen KI-generierten Bericht ungeprüft weitergibt, spart sich eine Stunde und kostet die Empfängerin zwei. Wie in der Wissenschaft gilt: Das Erzeugen ist billig geworden, das Prüfen nicht. Ein Unternehmen, das KI vor allem an der Menge des erzeugten Outputs misst, baut deshalb ungewollt die Situation nach, vor der arXiv gerade kapituliert.
Es lebe die Wissenschaft: Wie KI sie retten könnte
Trotz allem bin ich optimistisch. Die Krise legt offen, dass die Qualitätssicherung der Wissenschaft auf einer Annahme beruhte, die nicht mehr gilt: dass die Mühe des Schreibens als natürlicher Filter wirkt. Wenn dieser Filter wegfällt, müssen wir Prüfung bewusst gestalten. Darin liegt eine Chance.
Prüfen statt nur Erzeugen. Die naheliegendste Konsequenz ist, KI dort einzusetzen, wo der Engpass liegt. Werkzeuge können Dubletten und starke Überschneidungen erkennen, Quellenangaben automatisch gegen Datenbanken prüfen, statistische Angaben auf Konsistenz testen und Code reproduzieren. Das ersetzt keine fachliche Begutachtung, kann aber Moderator:innen und Gutachter:innen von Routinearbeit entlasten. Viele Kommentare zur arXiv-Regel fordern genau das: KI nicht nur auf der Seite der Autor:innen, sondern auch auf der Seite der Prüfenden (Boboris 2026).
Formale Verifikation nutzen, wo sie möglich ist, ohne sie zu überschätzen. In der Mathematik kann Lean einen Teil der Prüfarbeit übernehmen. Wie bei den OpenAI-Ergebnissen gesehen, prüft es aber nur, was formalisiert ist, und nur, ob ein Beweis zur formal aufgeschriebenen Aussage passt. Formalisieren ist aufwendig, wird mit KI aber schneller: Für Fermats letzten Satz startete Kevin Buzzard 2024 ein auf Jahre angelegtes Projekt; im September 2026 formalisierte Claude den Beweis in elf Tagen, allerdings mit rund 13 Millionen Zeilen Lean-Code, gut fünfmal so viel wie ganz Mathlib. Anthropic betont dabei selbst, dass formale Beweise menschenlesbare Erklärungen nicht ersetzen sollen (Anthropic 2026). Auch Lean selbst ist nicht fehlerfrei: Im Juli 2026 akzeptierte es eine KI-gestützte „Widerlegung“ der Collatz-Vermutung, die in Wahrheit einen Fehler im Kern des Programms ausnutzte. Behoben war er innerhalb einer Stunde (Moura 2026). Vor allem aber ersetzt eine formale Prüfung nicht das Verstehen; dazu gleich mehr.
In den empirischen Wissenschaften gibt es nichts Vergleichbares. Ob ein Experiment sauber durchgeführt wurde oder ein Befund sich verallgemeinern lässt, kann keine Maschine beweisen. Es gibt aber Bausteine für die Routineprüfung: ausführbarer Analysecode, offene Daten, vorab registrierte Analysepläne und automatische Konsistenzprüfungen. Schon einfache Werkzeuge finden viel. Mit statcheck fanden Nuijten u. a. (2016) in etwa der Hälfte der untersuchten Psychologie-Artikel mindestens einen p-Wert, der nicht zur angegebenen Teststatistik passte; in etwa jedem achten Artikel konnte die Abweichung die Schlussfolgerung verändern. Solche Werkzeuge prüfen Konsistenz, nicht Wahrheit. Sie entlasten Menschen aber genau dort, wo Prüfung mechanisch ist.
Neue Daten und neue Fragen werden wertvoller. KI ist besonders gut darin, Bekanntes neu zu kombinieren: Literatur zusammenzufassen oder öffentliche Datensätze nach immer gleichem Muster auszuwerten. Wie das aussieht, zeigen Suchak u. a. (2025) am Beispiel der frei verfügbaren US-Gesundheitsdatenbank NHANES. Zwischen 2014 und 2021 erschienen im Schnitt vier Studien pro Jahr, die jeweils einen einzelnen Faktor mit einer Erkrankung in Verbindung brachten; 2024 waren es bis Anfang Oktober bereits 190. Viele davon korrigieren nicht für multiples Testen oder wählen Zeiträume ohne Begründung aus. Was KI dagegen nicht erzeugen kann, sind neue Messungen, Experimente und Beobachtungen. Forschung, die neue Daten hervorbringt, dürfte deshalb an Wert gewinnen.
Das heißt nicht, dass die Neuanalyse vorhandener Daten wertlos wird. Sorgfältige Replikationen sind nach der Replikationskrise wichtiger denn je; die Grenze verläuft zwischen formelhaft und durchdacht, nicht zwischen alten und neuen Daten. Knapp bleiben zudem nicht nur neue Daten, sondern auch neue Fragen: Die OpenAI-Beweise zeigen, dass KI auch ohne neue Daten Ergebnisse hervorbringt, aber nicht automatisch Verständnis. Allerdings begünstigt das gut ausgestattete Gruppen, denn neue Daten zu erheben ist teuer. Und je wertvoller Daten werden, desto wichtiger wird ihre nachvollziehbare Herkunft, denn auch plausibel wirkende Daten lassen sich mit KI leichter fälschen.
Daraus folgt eine Verschiebung der wissenschaftlichen Arbeit selbst. Wenn KI Probleme schneller löst, wird es wichtiger, die richtigen Probleme zu finden und präzise zu formulieren: Welche Frage lohnt sich, welche Daten fehlen, was wäre überhaupt ein interessantes Ergebnis? Das gilt weit über die Wissenschaft hinaus. Auch im Arbeitsalltag mit KI entscheidet die Qualität der Frage zunehmend über die Qualität der Antwort. Die Erklärung der Fields-Medaillenträger:innen benennt allerdings einen Haken: Die Fähigkeit, neue Fragen zu stellen, entsteht bislang gerade durch das mühsame eigene Arbeiten an Problemen. Übernimmt KI dieses Training, droht genau diese Fähigkeit zu verkümmern (Avila u. a. 2026). Ein ähnliches Argument habe ich für die Programmierausbildung gemacht: Studierende müssen coden lernen, gerade weil KI Code schreiben kann. Für die Ausbildung junger Forschender ist das eine der wichtigsten offenen Fragen.
Anreize verändern. Die Flut ist auch eine Folge von publish or perish. Solange Karrieren an der Zahl der Publikationen hängen, ist es rational, mit KI mehr zu publizieren. arXiv spricht ausdrücklich davon, dass Autor:innen nur ihre beste Arbeit einreichen sollen. Die ICML 2026, eine der großen KI-Konferenzen, geht noch weiter und bezieht erstmals Rankings in ihre Entscheidungen ein, in denen Autor:innen ihre eigenen Einreichungen nach Qualität ordnen. In einem Experiment bei der ICML 2023 sagten solche Selbsteinschätzungen spätere Zitationen besser vorher als die Gutachten (Su u. a. 2025). Berufungs- und Förderverfahren, die nur eine kleine Zahl ausgewählter Arbeiten bewerten, würden den Druck zur Menge spürbar senken.
Prüfarbeit sichtbar machen und vergüten. Wenn Begutachtung der eigentliche Engpass ist, sollte sie auch so behandelt werden. Die Zeitschrift Biology Open etwa bezahlt Gutachter:innen inzwischen für fundierte Gutachten, die innerhalb von vier Arbeitstagen vorliegen (Naddaf 2026). Entscheidend ist, dass dies transparent geschieht und nicht in einem undurchsichtigen Markt für Schnellgutachten endet.
Ergebnis und Erklärung trennen. Die OpenAI-Veröffentlichung zeigt schließlich, dass ein korrektes Ergebnis allein noch keinen wissenschaftlichen Fortschritt bedeutet. Wissen entsteht erst, wenn Menschen ein Ergebnis verstehen, einordnen und weitergeben können. Künftig könnte die eigentliche wissenschaftliche Leistung häufiger darin bestehen, maschinell erzeugte Ergebnisse zu prüfen, zu erklären und mit bestehendem Wissen zu verbinden. Die Kryptografin Dakshita Khurana, die jahrelang an einem der nun beanspruchten Probleme gearbeitet hat, beschreibt das laut Schuler (2026) sinngemäß so: Auch wenn jemand anderes den Gipfel auf einer anderen Route erreicht hat, sieht man von dort oben neue Berge, die man nun mit Studierenden, Kolleg:innen und Maschinen besteigen kann.
Was Unternehmen daraus lernen können
Für Unternehmen lassen sich aus der Wissenschaftskrise einige recht konkrete Konsequenzen ableiten:
- Prüfkapazität ist die knappe Ressource. Wer KI einführt, sollte nicht nur fragen, wie viel schneller Ergebnisse entstehen, sondern wer sie prüft und wie viel Zeit dafür zur Verfügung steht. Die Kapazität für Review sollte genauso geplant werden wie Budget oder Rechenleistung.
- Verantwortung liegt bei der Person, die weitergibt. arXiv zählt Einreichungen bei der Person, die auf „Absenden“ klickt. Übertragen heißt das: Wer ein KI-gestütztes Arbeitsergebnis weitergibt, verantwortet seinen Inhalt, prüft ihn vorher selbst und legt offen, wo KI beteiligt war. Das ist keine Misstrauensgeste, sondern hilft der empfangenden Person, ihren Prüfaufwand einzuschätzen.
- Ergebnisse statt Output messen. Zahl der erzeugten Dokumente, Folien oder Codezeilen sind schlechte Erfolgsmaße. Relevanter sind Entscheidungsqualität, Durchlaufzeit bis zu einem tatsächlich genutzten Ergebnis und Fehlerraten.
- Erst Prüfung automatisieren, dann Erzeugung skalieren. Tests, Evaluationen, Checklisten und Plausibilitätsprüfungen sind das betriebliche Gegenstück zu Lean. Solange sie fehlen, sind auch Begrenzungen legitim: Ein Limit für gleichzeitig offene Vorgänge, wie es arXiv mit drei aktiven Einreichungen kennt, zwingt dazu, das Beste auszuwählen, statt alles weiterzureichen.
- Eigene Daten und eigenes Wissen pflegen. Generische Analysen und Texte werden austauschbar, weil alle sie mit denselben Modellen erzeugen können. Den Unterschied machen eigene Daten, eigenes Prozesswissen und die Fähigkeit, die richtigen neuen Fragen zu stellen.
Fazit
Die Wissenschaft erlebt gerade, was viele Organisationen noch vor sich haben. Generative KI senkt die Kosten der Erzeugung von Texten, Code und sogar Beweisen dramatisch. Die Kosten der Prüfung sinken nicht im selben Maß. Ein System, dessen Qualitätssicherung stillschweigend auf der Mühe des Schreibens beruhte, gerät dadurch aus dem Gleichgewicht.
Die Notbremse von arXiv ist deshalb verständlich, aber keine Lösung. Ein Limit verringert die Menge, unterscheidet aber nicht zwischen guter und schlechter Arbeit. Dauerhaft wird es darauf ankommen, Prüfung selbst zu skalieren und die Verantwortung dafür bei denen zu lassen, die etwas erzeugen.
In diesem Sinn ist der Titel weniger pessimistisch gemeint, als er klingt. Eine bestimmte Form, Wissenschaft zu organisieren, kommt an ihr Ende. Was danach kommt, kann besser sein – wenn wir KI nicht nur zum Schreiben, sondern vor allem zum Prüfen einsetzen. Für Unternehmen gilt dasselbe.
Literatur
AAAS. 2022. „AAAS Survey: Many Researchers Face Difficulties Paying Open Access Fees“. 2022. https://www.aaas.org/news/aaas-survey-many-researchers-face-difficulties-paying-open-access-fees.
Aaronson, Scott. 2026. „The Mathocalypse“. Shtetl-Optimized. 7. Oktober 2026. https://scottaaronson.blog/?p=10169.
Aczel, Balazs, Barnabas Szaszi, und Alex O. Holcombe. 2021. „A Billion-Dollar Donation: Estimating the Cost of Researchers’ Time Spent on Peer Review“. Research Integrity and Peer Review 6: 14. https://doi.org/10.1186/s41073-021-00118-2.
Anthropic. 2026. „Formalizing Fermat’s Last Theorem“. 4. September 2026. https://www.anthropic.com/news/formalizing-fermats-last-theorem.
arXiv. 2025. „Attention Authors: Updated Endorsement Policy for arXiv Mathematics“. arXiv Blog. 10. Dezember 2025. https://blog.arxiv.org/2025/12/10/updated-endorsement-policy-for-arxiv-mathematics/.
———. 2026. „arXiv Monthly Submissions“. 19. September 2026. https://arxiv.org/stats/monthly_submissions.
Avila, Artur u. a. 2026. „A Severe Misalignment of AI in Mathematics“. 11. September 2026. https://doi.org/10.5281/zenodo.22737750.
Axios. 2025. „AI „Workslop" Sabotages Productivity, Study Finds“. 24. September 2025. https://www.axios.com/2025/09/24/ai-workslop-workplace-efficiency-study.
Boboris, Kat. 2025. „Attention Authors: Updated Practice for Review Articles and Position Papers in arXiv CS Category“. arXiv Blog. 31. Oktober 2025. https://blog.arxiv.org/2025/10/31/attention-authors-updated-practice-for-review-articles-and-position-papers-in-arxiv-cs-category/.
———. 2026. „Fair Moderation, Equitable Access, and AI: arXiv’s Updated Rate Limit Policy“. arXiv Blog. 1. Oktober 2026. https://blog.arxiv.org/2026/10/01/updated-rate-limit-policy/.
Dobusch, Leonhard. 2019. „Neuer Vertrag, neue Zeitschrift: Immer mehr Wissenschaft wird Open Access“. netzpolitik.org. 17. Januar 2019. https://netzpolitik.org/?p=212937.
Elsevier. 2025. „Researcher of the Future: A Confidence in Research Report“. 2025. https://www.elsevier.com/en-in/insights/confidence-in-research/researcher-of-the-future.
engrXiv. 2025. „AI Slop“. engrXiv Blog. 26. August 2025. https://blog.engrxiv.org/2025/08/ai-slop.
Federal Trade Commission. 2019. „Federal Trade Commission v. OMICS Group Inc.“ 2019. https://www.ftc.gov/enforcement/cases-proceedings/152-3113/federal-trade-commission-v-omics-group-inc.
Grove, Jack. 2026. „Ban for Authors Submitting AI Content „Welcome but Unenforceable““. Times Higher Education. 20. Mai 2026. https://www.timeshighereducation.com/node/743014.
Hanson, Mark A., Pablo Gómez Barreiro, Paolo Crosetto, und Dan Brockington. 2024. „The Strain on Scientific Publishing“. Quantitative Science Studies 5 (4): 823–43. https://doi.org/10.1162/qss_a_00327.
Haven, Tamarinde L., Lex M. Bouter, Yvo M. Smulders, und Joeri K. Tijdink. 2019. „Perceived Publication Pressure in Amsterdam: Survey of All Disciplinary Fields and Academic Ranks“. PLOS ONE 14 (6): e0217931. https://doi.org/10.1371/journal.pone.0217931.
Jiang, Shan. 2025. „Tenure Under Pressure: Simulating the Disruptive Effects of AI on Academic Publishing“. 2025. https://arxiv.org/abs/2509.16925.
Larivière, Vincent, Stefanie Haustein, und Philippe Mongeon. 2015. „The Oligopoly of Academic Publishers in the Digital Era“. PLOS ONE 10 (6): e0127502. https://doi.org/10.1371/journal.pone.0127502.
Lean Community. 2026. „Mathlib Statistics“. 2026. https://leanprover-community.github.io/mathlib_stats.html.
Lean FRO. 2026. „Lean Programming Language“. 2026. https://lean-lang.org/.
Moura, Leonardo de. 2026. „Postmortem for Kernel Soundness Bug #14576“. 1. August 2026. https://leodemoura.github.io/blog/2026-8-1-postmortem-for-kernel-soundness-bug-14576/.
Naddaf, Miryam. 2025. „Major AI Conference Flooded with Peer Reviews Written Fully by AI“. Nature. 27. November 2025. https://doi.org/10.1038/d41586-025-03506-6.
———. 2026. „Paid to Peer Review: Firms Are Paying Researchers to Assess Manuscripts for Journals“. Nature 658: 306. https://doi.org/10.1038/d41586-026-02277-y.
Niederhoffer, Kate, Gabriella Rosen Kellerman, Angela Lee, Alex Liebscher, Kristina Rapuano, und Jeffrey T. Hancock. 2025. „AI-Generated „Workslop" Is Destroying Productivity“. Harvard Business Review. 22. September 2025. https://hbr.org/2025/09/ai-generated-workslop-is-destroying-productivity.
Nuijten, Michèle B., Chris H. J. Hartgerink, Marcel A. L. M. van Assen, Sacha Epskamp, und Jelte M. Wicherts. 2016. „The Prevalence of Statistical Reporting Errors in Psychology (1985–2013)“. Behavior Research Methods 48 (4): 1205–26. https://doi.org/10.3758/s13428-015-0664-2.
open-access.network. 2023. „Elsevier und DEAL schließen Open-Access-Vertrag“. 2023. https://open-access.network/services/news/artikel/elsevier-und-deal-schliessen-open-access-vertrag.
OpenAI. 2026a. „openai/math: Mathematical Manuscripts and Proof Artifacts“. GitHub. 6. Oktober 2026. https://github.com/openai/math.
———. 2026b. „Sharing AI Progress in Mathematics“. 6. Oktober 2026. https://openai.com/index/sharing-ai-progress-in-mathematics/.
Pangram Labs. 2025. „Pangram Predicts 21% of ICLR Reviews Are AI-Generated“. 18. November 2025. https://www.pangram.com/blog/pangram-predicts-21-of-iclr-reviews-are-ai-generated.
Paruzel-Czachura, Mariola, Lidia Baran, und Zbigniew Spendel. 2021. „Publish or Be Ethical? Publishing Pressure and Scientific Misconduct in Research“. Research Ethics 17 (3): 375–97. https://doi.org/10.1177/1747016120980562.
Pottarath, Amna, Willem Halffman, und Serge Horbach. 2026. „Platform Peers: The Little-Known Market for Peer Reviews“. MetaArXiv. 8. September 2026. https://doi.org/10.31222/osf.io/2wq3b_v1.
Price, Gary. 2025. „Report: AI Content Is Tainting Preprints: How Moderators Are Fighting Back“. infoDOCKET. 12. August 2025. https://www.infodocket.com/2025/08/12/report-ai-content-is-tainting-preprints-how-moderators-are-fighting-back/.
RELX. 2025. „Annual Report 2024: Scientific, Technical & Medical“. 13. Februar 2025. https://www.sec.gov/Archives/edgar/data/929869/000092986925000025/tmb-20250213xex99d1.htm.
———. 2026. „Results 2025: Results Presentation“. 12. Februar 2026. https://www.relx.com/~/media/Files/R/RELX-Group/documents/results/results-presentations/2025-results-presentation.pdf.
Schuler, Marcus. 2026. „OpenAI’s 372 Math Results Leave Mathematicians Racing to Read the Proofs“. Implicator.ai. 8. Oktober 2026. https://www.implicator.ai/openai-372-math-results-mathematicians-race-to-read/.
Springer Nature. 2026. „Early Career Researchers Lead Shift towards AI-First Discovery“. 20. Juli 2026. https://group.springernature.com/de/group/media/press-releases/early-career-researchers-lead-shift-towards-ai-first-discovery/52988132.
Su, Buxin, Natalie Collina, Garrett Wen, Didong Li, Kyunghyun Cho, Jianqing Fan, Bingxin Zhao, und Weijie Su. 2025. „How to Find Fantastic AI Papers: Self-Rankings as a Powerful Predictor of Scientific Impact Beyond Peer Review“. 2025. https://arxiv.org/abs/2510.02143.
Suchak, Tulsi, Anietie E. Aliu, Charlie Harrison, Reyer Zwiggelaar, Nophar Geifman, und Matt Spick. 2025. „Explosion of Formulaic Research Articles, Including Inappropriate Study Designs and False Discoveries, Based on the NHANES US National Health Database“. PLOS Biology 23 (5): e3003152. https://doi.org/10.1371/journal.pbio.3003152.
Times Higher Education. 2026. „arXiv’s New Preprint Submission Cap Divides Opinion“. 2. Oktober 2026. https://www.timeshighereducation.com/node/745300.
Van Noorden, Richard. 2014. „Publishers Withdraw More than 120 Gibberish Papers“. Nature, Februar. https://doi.org/10.1038/nature.2014.14763.
Watson, Traci. 2025. „AI Content Is Tainting Preprints: How Moderators Are Fighting Back“. Nature. 12. August 2025. https://doi.org/10.1038/d41586-025-02469-y.