Deskriptive Statistik
Die deskriptiven Ergebnisse zeigen, dass die Stichprobe repräsentativ ist (siehe Tabelle 3.1).
Externe Abbildung
Die Prozessvisualisierung in Abbildung 4.1 zeigt den Ablauf der Datenerhebung.
Hypothesentests
Die Ergebnisse der Hypothesentests sind in Tabelle 4.1 dargestellt.
Tabelle 4.1 zeigt, dass H1 und H2 bestätigt werden können (p < .05), während H3 abgelehnt werden muss.
Regressionsanalyse
R-Code mit Tabelle
library(broom)

# Simulierte Regression
set.seed(42)
n <- 200
age <- rnorm(n, 35, 8)
education <- rnorm(n, 14, 2)
income <- 20000 + 800 * age + 1500 * education + rnorm(n, 0, 8000)

model <- lm(income ~ age + education)
tidy_model <- broom::tidy(model)

knitr::kable(tidy_model,
             digits = 3,
             col.names = c("Prädiktor", "b", "SE", "t", "p"))
Die Regressionsergebnisse in Tabelle 4.2 bestätigen die Hypothesen.
Python-Code mit Abbildung
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

np.random.seed(42)
residuals = np.random.normal(0, 1, 100)

fig, axes = plt.subplots(1, 2, figsize=(10, 4))

axes[0].hist(residuals, bins=20, edgecolor='white', color='steelblue')
axes[0].set_title('Histogramm der Residuen')
axes[0].set_xlabel('Residuen')

_ = stats.probplot(residuals, dist="norm", plot=axes[1])
axes[1].set_title('Q-Q-Plot')
Text(0.5, 1.0, 'Q-Q-Plot')
plt.tight_layout()
plt.show()
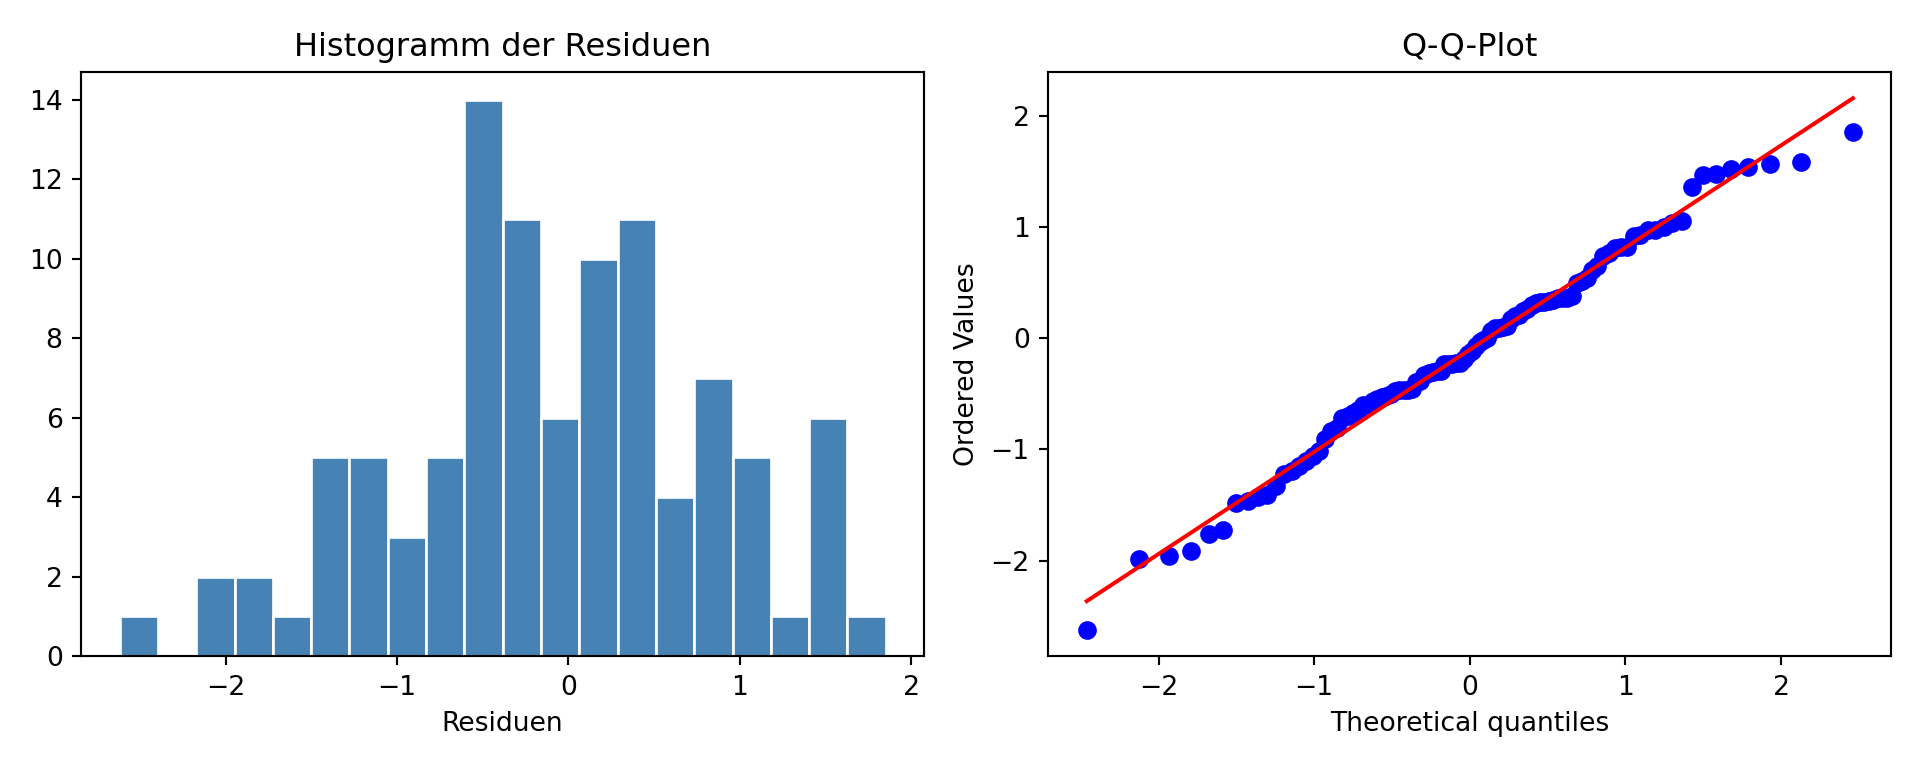
Die Residuenanalyse in Abbildung 4.2 zeigt keine Verletzungen der Annahmen.