Forschungsdesign
Diese Studie verwendet ein quantitatives Forschungsdesign…
Inline-Code: Der p-Wert beträgt 0.001 und ist somit signifikant.
Datenerhebung
Die Daten wurden erhoben durch…
Datenanalyse
Zur Analyse wurden folgende Methoden angewendet:
R-Code (sichtbar)
library (tibble)<- tibble (variable = c ("Alter" , "Einkommen" , "Bildungsjahre" ),mean = c (35.2 , 45600 , 14.3 ),sd = c (8.4 , 12500 , 2.1 ),n = c (250 , 250 , 250 ):: kable (data, caption = "Deskriptive Statistik" ,digits = 1 )
Siehe Tabelle 3.1 für die deskriptiven Statistiken.
R-Code (unsichtbar, nur Output)
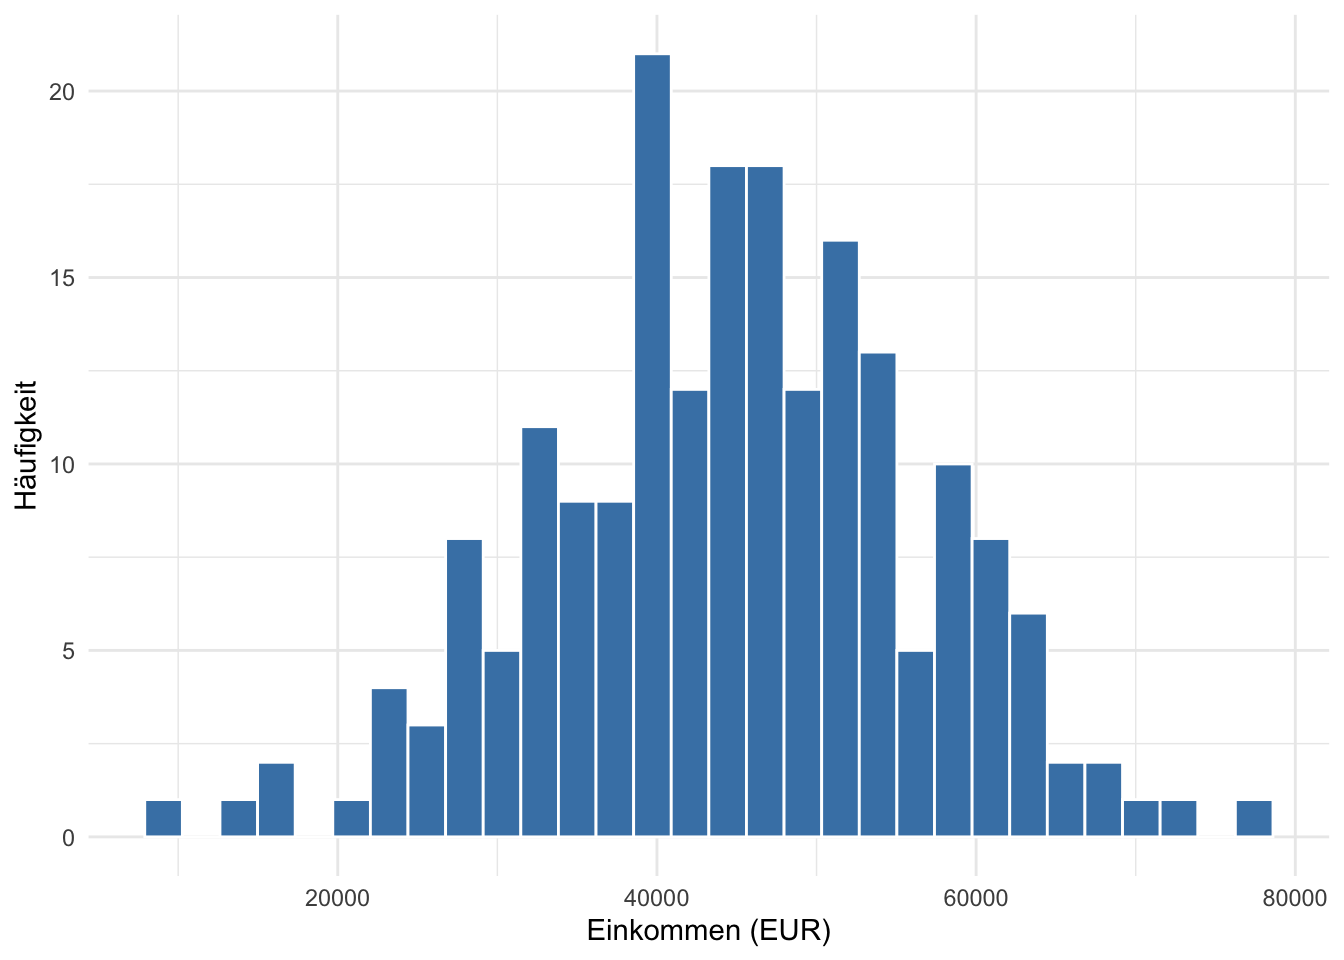
Die Verteilung der Einkommen ist in Abbildung 3.1 dargestellt.
Python-Code (sichtbar)
import pandas as pdimport numpy as np42 )= pd.DataFrame({'Alter' : np.random.normal(35 , 8 , 100 ),'Einkommen' : np.random.normal(45000 , 12000 , 100 ),'Bildung' : np.random.normal(14 , 2 , 100 )= df.corr().round (2 )print (corr)
           Alter  Einkommen  Bildung
Alter       1.00      -0.14     0.19
Einkommen  -0.14       1.00    -0.04
Bildung     0.19      -0.04     1.00
Die Korrelationen werden im Code-Output ausgegeben.
Python-Code (unsichtbar)
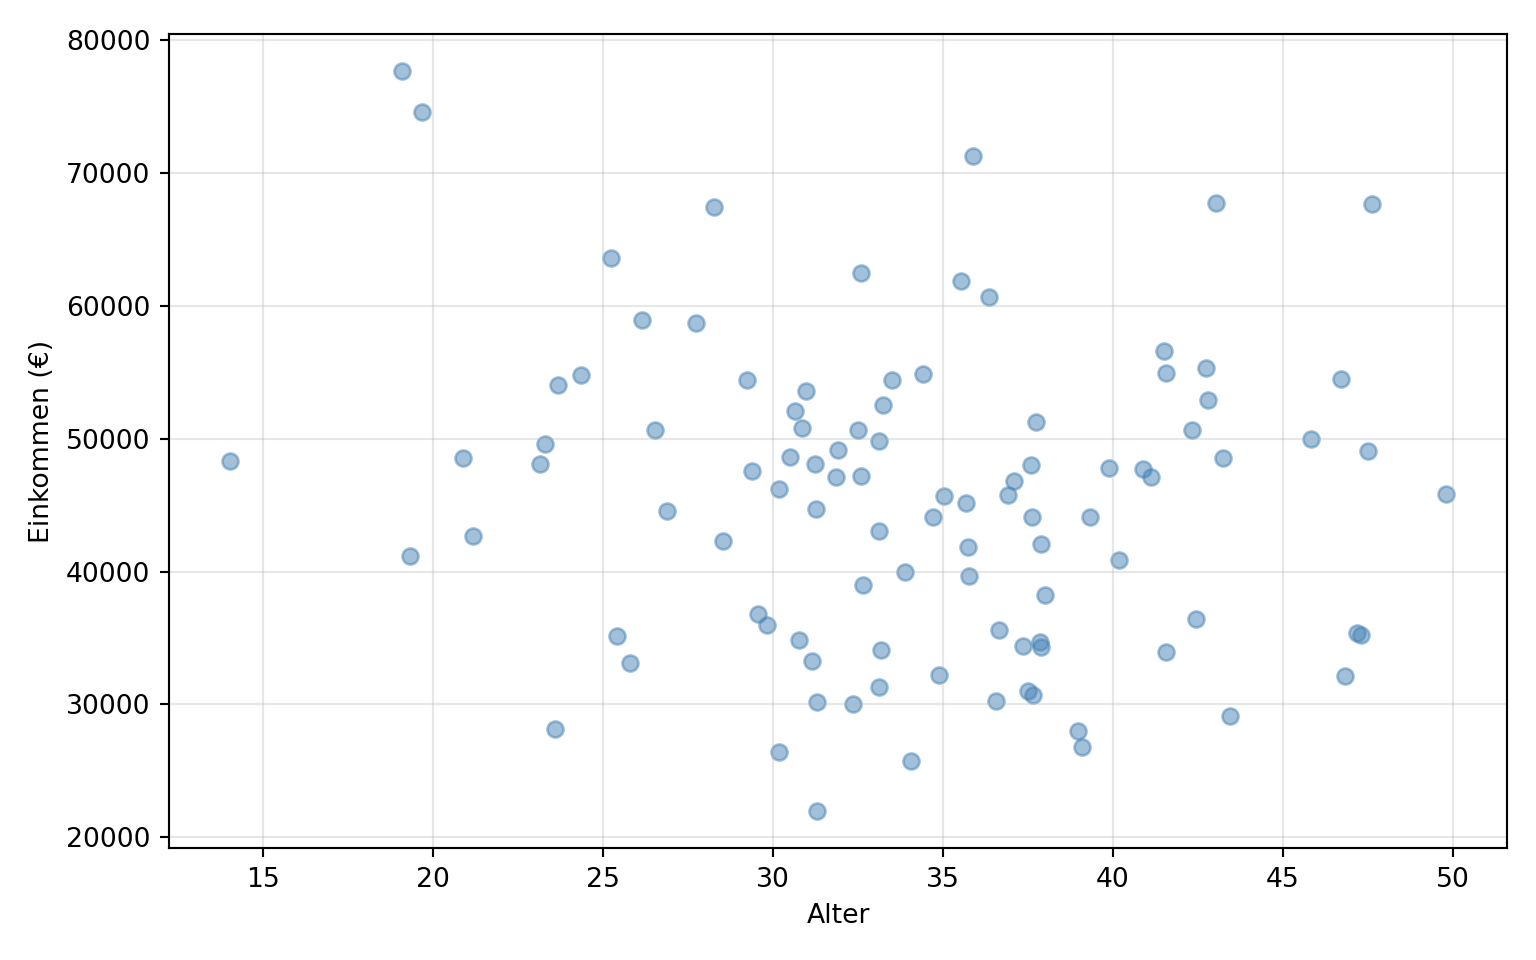
Abbildung 3.2 zeigt den Zusammenhang zwischen Alter und Einkommen.
Statistische Modellierung
Die Regressionsanalyse basiert auf folgendem Modell:
\[
Y_i = \beta_0 + \beta_1 X_{1i} + \beta_2 X_{2i} + \varepsilon_i, \quad \varepsilon_i \sim \mathcal{N}(0, \sigma^2)
\tag{3.1}\]
Gleichung 3.1 beschreibt das lineare Regressionsmodell, wobei \(Y_i\) das Einkommen, \(X_{1i}\) das Alter und \(X_{2i}\) die Bildungsjahre der Person \(i\) darstellen.